


 首页



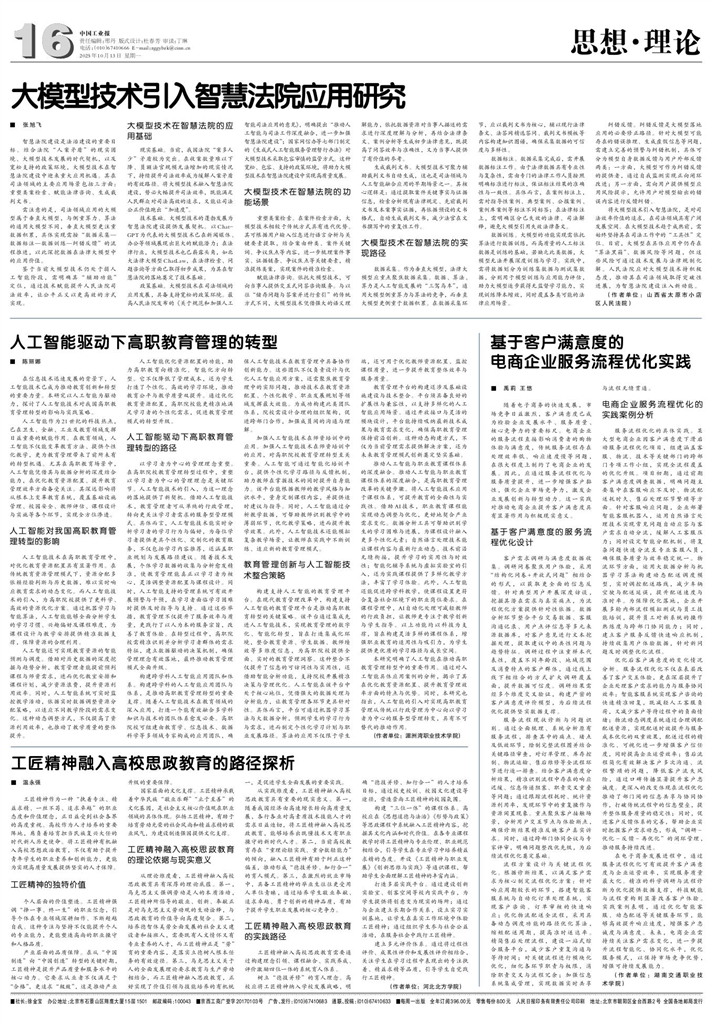
■ 张旭飞
智慧法院建设是法治建设的重要目标。结合法院“人案矛盾”的现实困境、大模型技术发展的时代契机,以及宽松支持的政策环境,大模型技术在智慧法院建设中迎来重大应用机遇。其在司法领域的主要应用场景包括三方面:重塑类案检索、赋能法律咨询、生成裁判文书。
需注意的是,司法领域应用的大模型属于垂直大模型,与侧重算力、算法的通用大模型不同,垂直大模型更注重数据积累,具体实现需按“数据采集—数据标注—数据训练—纠错反馈”的流程推进,以此深挖数据在法律大模型中的应用价值。
鉴于当前大模型技术仍处于弱人工智能阶段,需明确其“辅助功能”定位,通过技术赋能提升人民法院司法效率,让公平正义以更高效的方式实现。
大模型技术在智慧法院的应用基础
现实基础。当前,我国法院“案多人少”矛盾较为突出。在收案数量难以下降、员额法官规模无法增加的现实情况下,持续提升司法效率成为缓解人案矛盾的有效路径。将大模型技术融入智慧法院建设,势必大幅提升司法效率,既能满足人民群众对司法高效的追求,又能让司法公正价值跑出“加速度”。
技术基础。大模型技术的蓬勃发展为智慧法院建设提供发展契机。以ChatGPT为代表的大模型技术已在新闻媒体、办公等领域展现出巨大的赋能潜力;在法律行业,大模型技术也已崭露头角,如北大法律大模型ChatLaw,在法律检索、问题咨询等方面已取得初步成果,为其在智慧法院的落地奠定了技术基础。
政策基础。大模型技术在司法领域的应用发展,具备支持宽松的政策环境。最高人民法院发布的《关于规范和加强人工智能司法应用的意见》,明确提出“推动人工智能与司法工作深度融合,进一步加强智慧法院建设”;国家网信办等七部门制定的《生成式人工智能服务管理暂行办法》对大模型技术采取包容审慎的监管方式。这种宽松、包容、支持的政策环境,将助力大模型技术在智慧法院建设中实现高质量发展。
大模型技术在智慧法院的功能场景
重塑类案检索。在案件检索方面,大模型技术相较于传统方式具有迭代优势。其可根据用户输入信息进行语言分析与关键要素提取,结合案由种类、案件关键词、争议焦点等内容,进一步梳理案件事实、证据链条、争议焦点等关键要素,精准提炼类案,实现案件的精准检索。
赋能法律咨询。依托大模型技术,可向当事人提供交互式问答咨询服务。与以往“储存问题与答案并进行索引”的传统方式不同,大模型技术凭借强大的语义理解能力,依托数据资源对当事人描述的需求进行深度理解与分析,再结合法律条文、案例分析等生成初步法律意见,既提高了问答效率与准确性,又为当事人提供了有价值的参考。
生成裁判文书。大模型技术可聚力辅助裁判文书自动生成,这也是司法领域与人工智能融合应用的早期场景之一。其核心逻辑是:通过提取案件关键事实与证据信息,检索分析现有法律规定、先前裁判文书及本案事实证据,再依据预设的文书格式,自动生成裁判文书,减少法官在文书撰写中的重复性工作。
大模型技术在智慧法院的实现路径
数据采集。作为垂直大模型,法律大模型应重点聚焦数据采集。数据、算法、算力是人工智能发展的“三驾马车”,通用大模型侧重算力与算法的竞争,而垂直大模型更侧重于数据积累。在数据采集环节,应以裁判文书为核心,辅以现行法律条文、法答网精选答问、裁判文书模板等内容构建知识图谱,确保采集数据的可信度与多样性。
数据标注。数据采集完成后,需开展数据标注工作。由于法律数据具有专业性与复杂性,需由专门的法律工作人员按照明确标准进行标注,保证标注结果的准确性与一致性。具体而言,在案例标注上,需对指导性案例、典型案例、公报案例、案例库案例等标注不同标签;在法律标注上,需明确区分已失效的法律、司法解释,避免大模型引用失效法律条文。
数据训练。大模型的功能实现需依托算法进行数据训练,而高质量的人工标注数据是训练的基础,若缺乏此类数据,大模型无法开展深度训练与学习。实践中,需将数据划分为训练集数据与测试集数据,分别用于模型训练与应用能力评估,助力大模型逐步获得无监督学习能力,实现训练降本增效,同时覆盖各类可能的法律应用场景。
纠错反馈。纠错反馈是大模型落地应用的必要修正路径。针对大模型可能存在的错误推理、生成虚假信息等问题,需建立完善的预警与纠错机制,具体可分为模型自身数据反馈与用户外部反馈两类:一方面,大模型可作为纠错反馈的提供者,通过自我监测实现正向闭环改进;另一方面,需向用户提供模型应用风险提示,允许用户对模型输出的错误内容进行反馈纠错。
将大模型技术引入智慧法院,是对司法效率价值的追求,在司法领域具有广阔发展空间。在大模型技术趋于成熟前,需始终坚持其在司法工作中的“工具性”定位。目前,大模型在具体应用中仍存在“算法黑箱”、数据风险等问题,但这些风险可通过技术发展与法律规制化解。人民法院应对大模型技术持积极态度,推动其在司法领域取得突破性进展,为智慧法院建设注入新动能。
(作者单位:山西省太原市小店区人民法院)
 放大
 上一版